Open-world Vision
Foundation models for open-vocabulary segmentation, detection, tracking, and compositional visual understanding.
Computer Vision · Embodied AI · Robotics
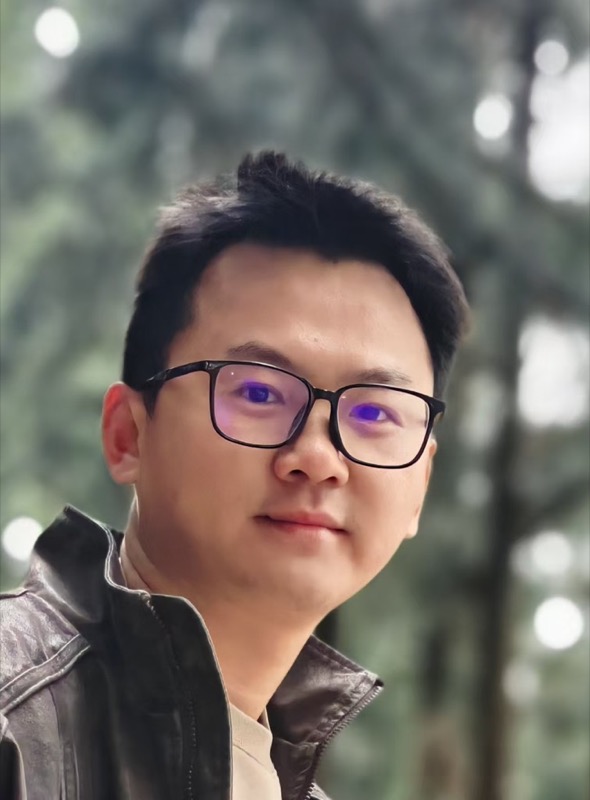
Ph.D. candidate in embodied intelligence. Research interests include multimodal models, vision-language-action systems, world models, robotic manipulation, autonomous systems, and visual tracking.
Research Interests
Foundation models for open-vocabulary segmentation, detection, tracking, and compositional visual understanding.
Vision-language-action models, world models, and Sim2Real learning for robotic manipulation and embodied decision making.
Multimodal models for perception, prediction, planning, and generalization in autonomous driving and navigation.
Data-centric training, model compression, edge inference, and evaluation protocols for deployable embodied intelligence.
Open Source
Selected repositories spanning open-world vision, DETR-based recognition, and Vision-Language-Action systems.
Core developer and contributor.
Grounded SAM: open-world detect, segment, and generate by combining Grounding DINO with Segment Anything.
Research platform for DETR-based detection, segmentation, pose estimation, and related visual recognition tasks.
Lego-like codebase for Vision-Language-Action model development, training, and deployment.
Experience & Education
Research spans embodied AI, computer vision, and multimodal systems, with experience at enacta ai, Meituan, and ArcSoft.
Current work studies robotic manipulation, VLA models, world models, multi-camera perception, simulation, and evaluation.
Ph.D. candidate in embodied intelligence; M.S., Xi'an Jiaotong University.
B.S. in Automation, UESTC.
Selected Publications
Selected publications spanning embodied AI, robotic manipulation, multimodal models, tracking, and autonomous driving.
Contact
For research collaboration and academic inquiries, please contact by email or via Google Scholar.
Guestbook
Comments
Leave a short note. Spam is filtered; please keep it friendly.